原文:A postmortem of three recent issues
作者:Sam McAllister / Anthropic
原文发布日期:2025 年 9 月 17 日
本文依据保存的原文完整翻译,原文版权归原权利人所有。
从 8 月到 9 月初,三个基础设施 bug 间歇性地降低了 Claude 的回答质量。我们现在已经解决这些问题,希望解释发生了什么。
8 月初,一些用户开始报告 Claude 的回答质量下降。这些最初的报告很难与用户反馈的正常波动区分开来。到 8 月下旬,报告出现得越来越频繁,并且持续不断,促使我们展开调查,最终发现了三个彼此独立的基础设施 bug。
直白地说:我们从不因为需求量、一天中的时段或服务器负载而降低模型质量。用户报告的问题完全是基础设施 bug 导致的。
我们理解,用户期望 Claude 的质量保持一致。对于确保基础设施变更不影响模型输出,我们一直坚持极高的标准。在最近这些事件中,我们未能达到这一标准。以下复盘解释了哪里出了问题,为什么发现和解决问题所花的时间比我们希望的更长,以及我们正在作出哪些改变,以防止未来发生类似事件。
通常,我们不会分享这么详细的基础设施技术信息,但这些问题的影响范围和复杂程度,使得更全面的解释很有必要。
我们如何大规模提供 Claude 服务
我们通过自有 API、Amazon Bedrock,以及 Google Cloud 的 Vertex AI,向数百万用户提供 Claude 服务。我们将 Claude 部署在多个硬件平台上,即 AWS Trainium、NVIDIA GPU 和 Google TPU。这种方式提供了服务全球用户所需的容量与地理分布。
每个硬件平台都有不同的特性,需要进行特定优化。尽管存在这些差异,我们对模型实现有严格的等效性标准。我们的目标是,无论由哪个平台处理请求,用户都应获得相同质量的回答。这种复杂性意味着,任何基础设施变更都需要在所有平台和配置上经过认真验证。
事件时间线
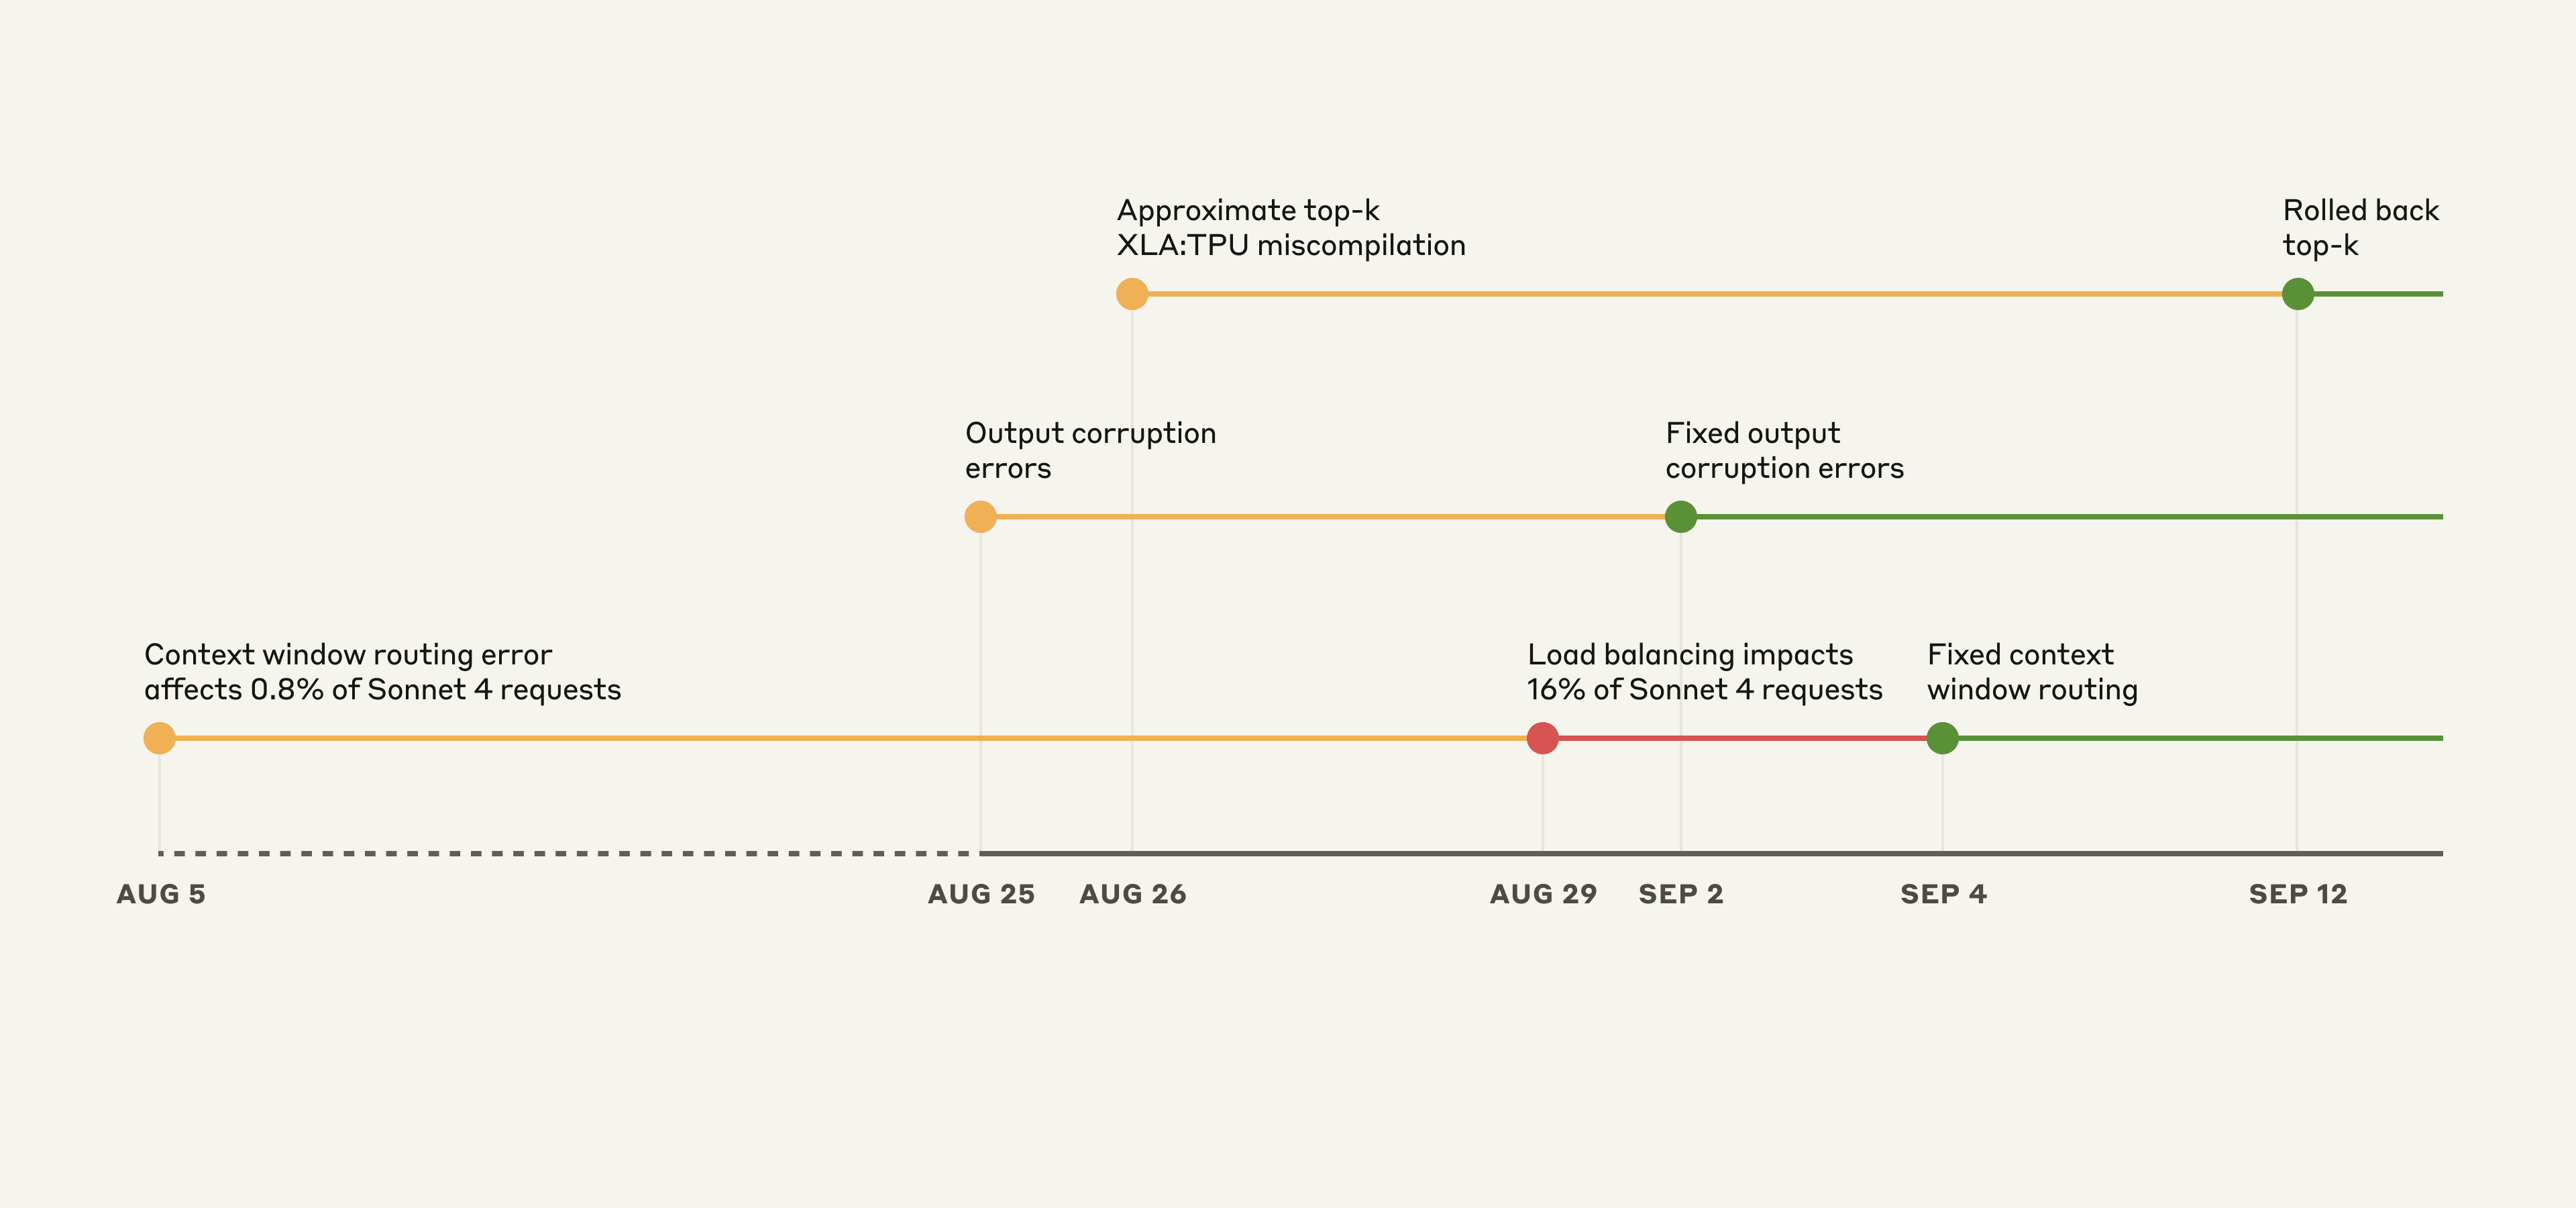
Claude API 事件时间线示意图。黄色:发现问题;红色:质量下降加剧;绿色:修复已部署。
这些 bug 相互重叠,使诊断尤为困难。第一个 bug 于 8 月 5 日引入,影响约 0.8% 的 Sonnet 4 请求。另外两个 bug 来自 8 月 25 日和 26 日的部署。
虽然最初影响有限,但 8 月 29 日的一次负载均衡变更,开始增加受影响的流量。这导致更多用户遇到问题,而其他用户仍然看到正常表现,从而形成令人困惑、彼此矛盾的报告。
三个相互重叠的问题
下面介绍造成质量下降的三个 bug、它们发生的时间,以及我们如何解决它们。
1. 上下文窗口路由错误
8 月 5 日,部分 Sonnet 4 请求被错误路由到为即将推出的 100 万 token上下文窗口配置的服务器。这个 bug 最初影响 0.8% 的请求。8 月 29 日,一次常规负载均衡变更,无意中增加了被路由到 100 万上下文服务器的短上下文请求数量。在 8 月 31 日受影响最严重的一个小时内,16% 的 Sonnet 4 请求受到影响。
在此期间发起请求的 Claude Code 用户中,约 30% 至少有一条消息被路由到错误类型的服务器,导致回答质量下降。在 Amazon Bedrock 上,自 8 月 12 日起,错误路由的流量占全部 Sonnet 4 请求的比例最高达到 0.18%。在 Google Cloud 的 Vertex AI 上,8 月 27 日至 9 月 16 日期间,错误路由影响的请求比例低于 0.0004%。
不过,一些用户受到的影响更加严重,因为我们的路由具有“粘性”。这意味着,一旦某个请求由错误的服务器处理,后续请求就很可能继续由同一个错误服务器处理。
解决方式: 我们修复了路由逻辑,确保短上下文和长上下文请求被发送到正确的服务器池。我们于 9 月 4 日部署修复。自有平台和 Google Cloud Vertex AI 的修复发布于 9 月 16 日完成,AWS Bedrock 则于 9 月 18 日完成。
2. 输出损坏
8 月 25 日,我们向 Claude API 的 TPU 服务器部署了一项错误配置,导致 token 生成期间发生错误。运行时性能优化引发的一个问题,偶尔会将较高概率赋给按照上下文本应极少生成的 token,例如在回答英文提示时生成泰文或中文字符,或者在代码中产生明显的语法错误。例如,一小部分用英文提问的用户,可能会在回答中途看到“สวัสดี”。
这种输出损坏影响了 8 月 25 日至 28 日的 Opus 4.1 和 Opus 4 请求,以及 8 月 25 日至 9 月 2 日的 Sonnet 4 请求。第三方平台未受此问题影响。
解决方式: 我们确定了问题,并于 9 月 2 日回滚变更。我们已经在部署流程中加入了用于检测意外字符输出的测试。
3. 近似 top-k 的 XLA:TPU 错误编译
8 月 25 日,我们部署了一段代码,用于改进 Claude 在文本生成时选择 token 的方式。这项变更无意中触发了 XLA:TPU 编译器中的一个潜在 bug [1],已确认影响 Claude Haiku 3.5 请求。
我们也认为,它可能影响了 Claude API 上的部分 Sonnet 4 和 Opus 3 请求。第三方平台未受此问题影响。
解决方式: 我们最先观察到这个 bug 影响 Haiku 3.5,并于 9 月 4 日回滚。后来,我们注意到用户对 Opus 3 问题的报告与此 bug 相符,于 9 月 12 日进行了回滚。经过广泛调查,我们未能在 Sonnet 4 上复现此 bug,但出于充分谨慎,仍决定回滚相关变更。
与此同时,我们已经:(a)与 XLA:TPU 团队合作修复编译器 bug;(b)发布了一项修复,改用精度更高的精确 top-k。详情请见下文的深入分析。
深入观察 XLA 编译器 bug
为了说明这些问题的复杂性,下面介绍 XLA 编译器 bug 如何表现出来,以及为什么它特别难以诊断。
Claude 生成文本时,会计算每个可能的下一个词的概率,再从这个概率分布中随机抽样。我们使用“top-p 采样”来避免无意义的输出:只考虑累计概率达到某个阈值的词,阈值通常为 0.99 或 0.999。在 TPU 上,我们的模型跨多个芯片运行,概率计算发生在不同位置。要对这些概率排序,就需要在芯片之间协调数据,这很复杂。[2]
2024 年 12 月,我们发现,当温度为零时,TPU 实现偶尔会丢弃概率最高的 token。我们部署了一个变通方案来修复这种情况。
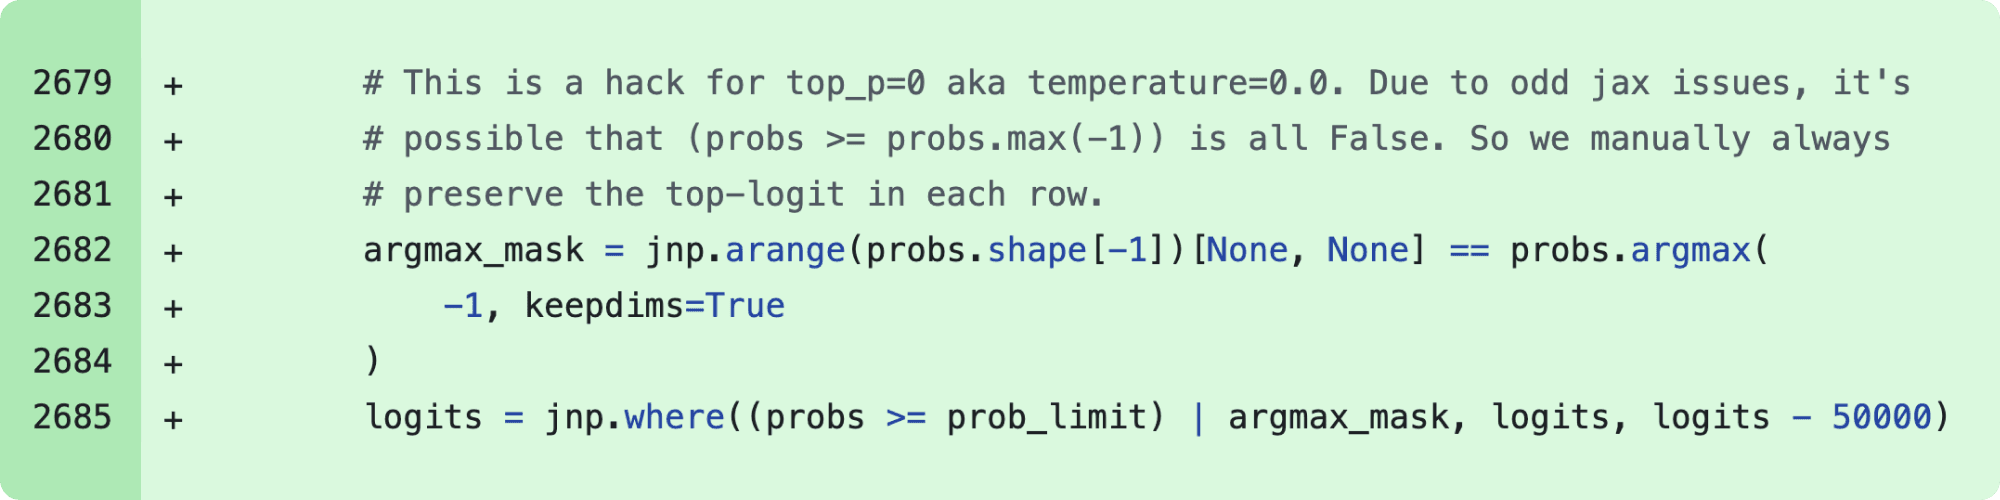
2024 年 12 月补丁的代码片段,用于绕过 temperature = 0 时意外丢弃 token 的 bug。
根本原因涉及混合精度运算。我们的模型使用 bf16(16 位浮点数)计算下一个 token 的概率。不过,向量处理器原生使用 fp32,因此 TPU 编译器 XLA 可以通过将某些操作转换为 fp32(32 位)来优化运行时。这项优化过程由 xla_allow_excess_precision 标志控制,默认值为 true。
这导致了不一致:原本应当对概率最高 token 得出相同结果的操作,使用了不同精度。精度不一致,意味着它们无法就哪个 token 的概率最高达成一致。这会导致概率最高的 token 有时完全从候选范围中消失。
8 月 26 日,我们部署了重写后的采样代码,修复精度问题,并改进了对达到 top-p 阈值边界的概率的处理。但在修复这些问题的过程中,我们暴露了一个更棘手的问题。
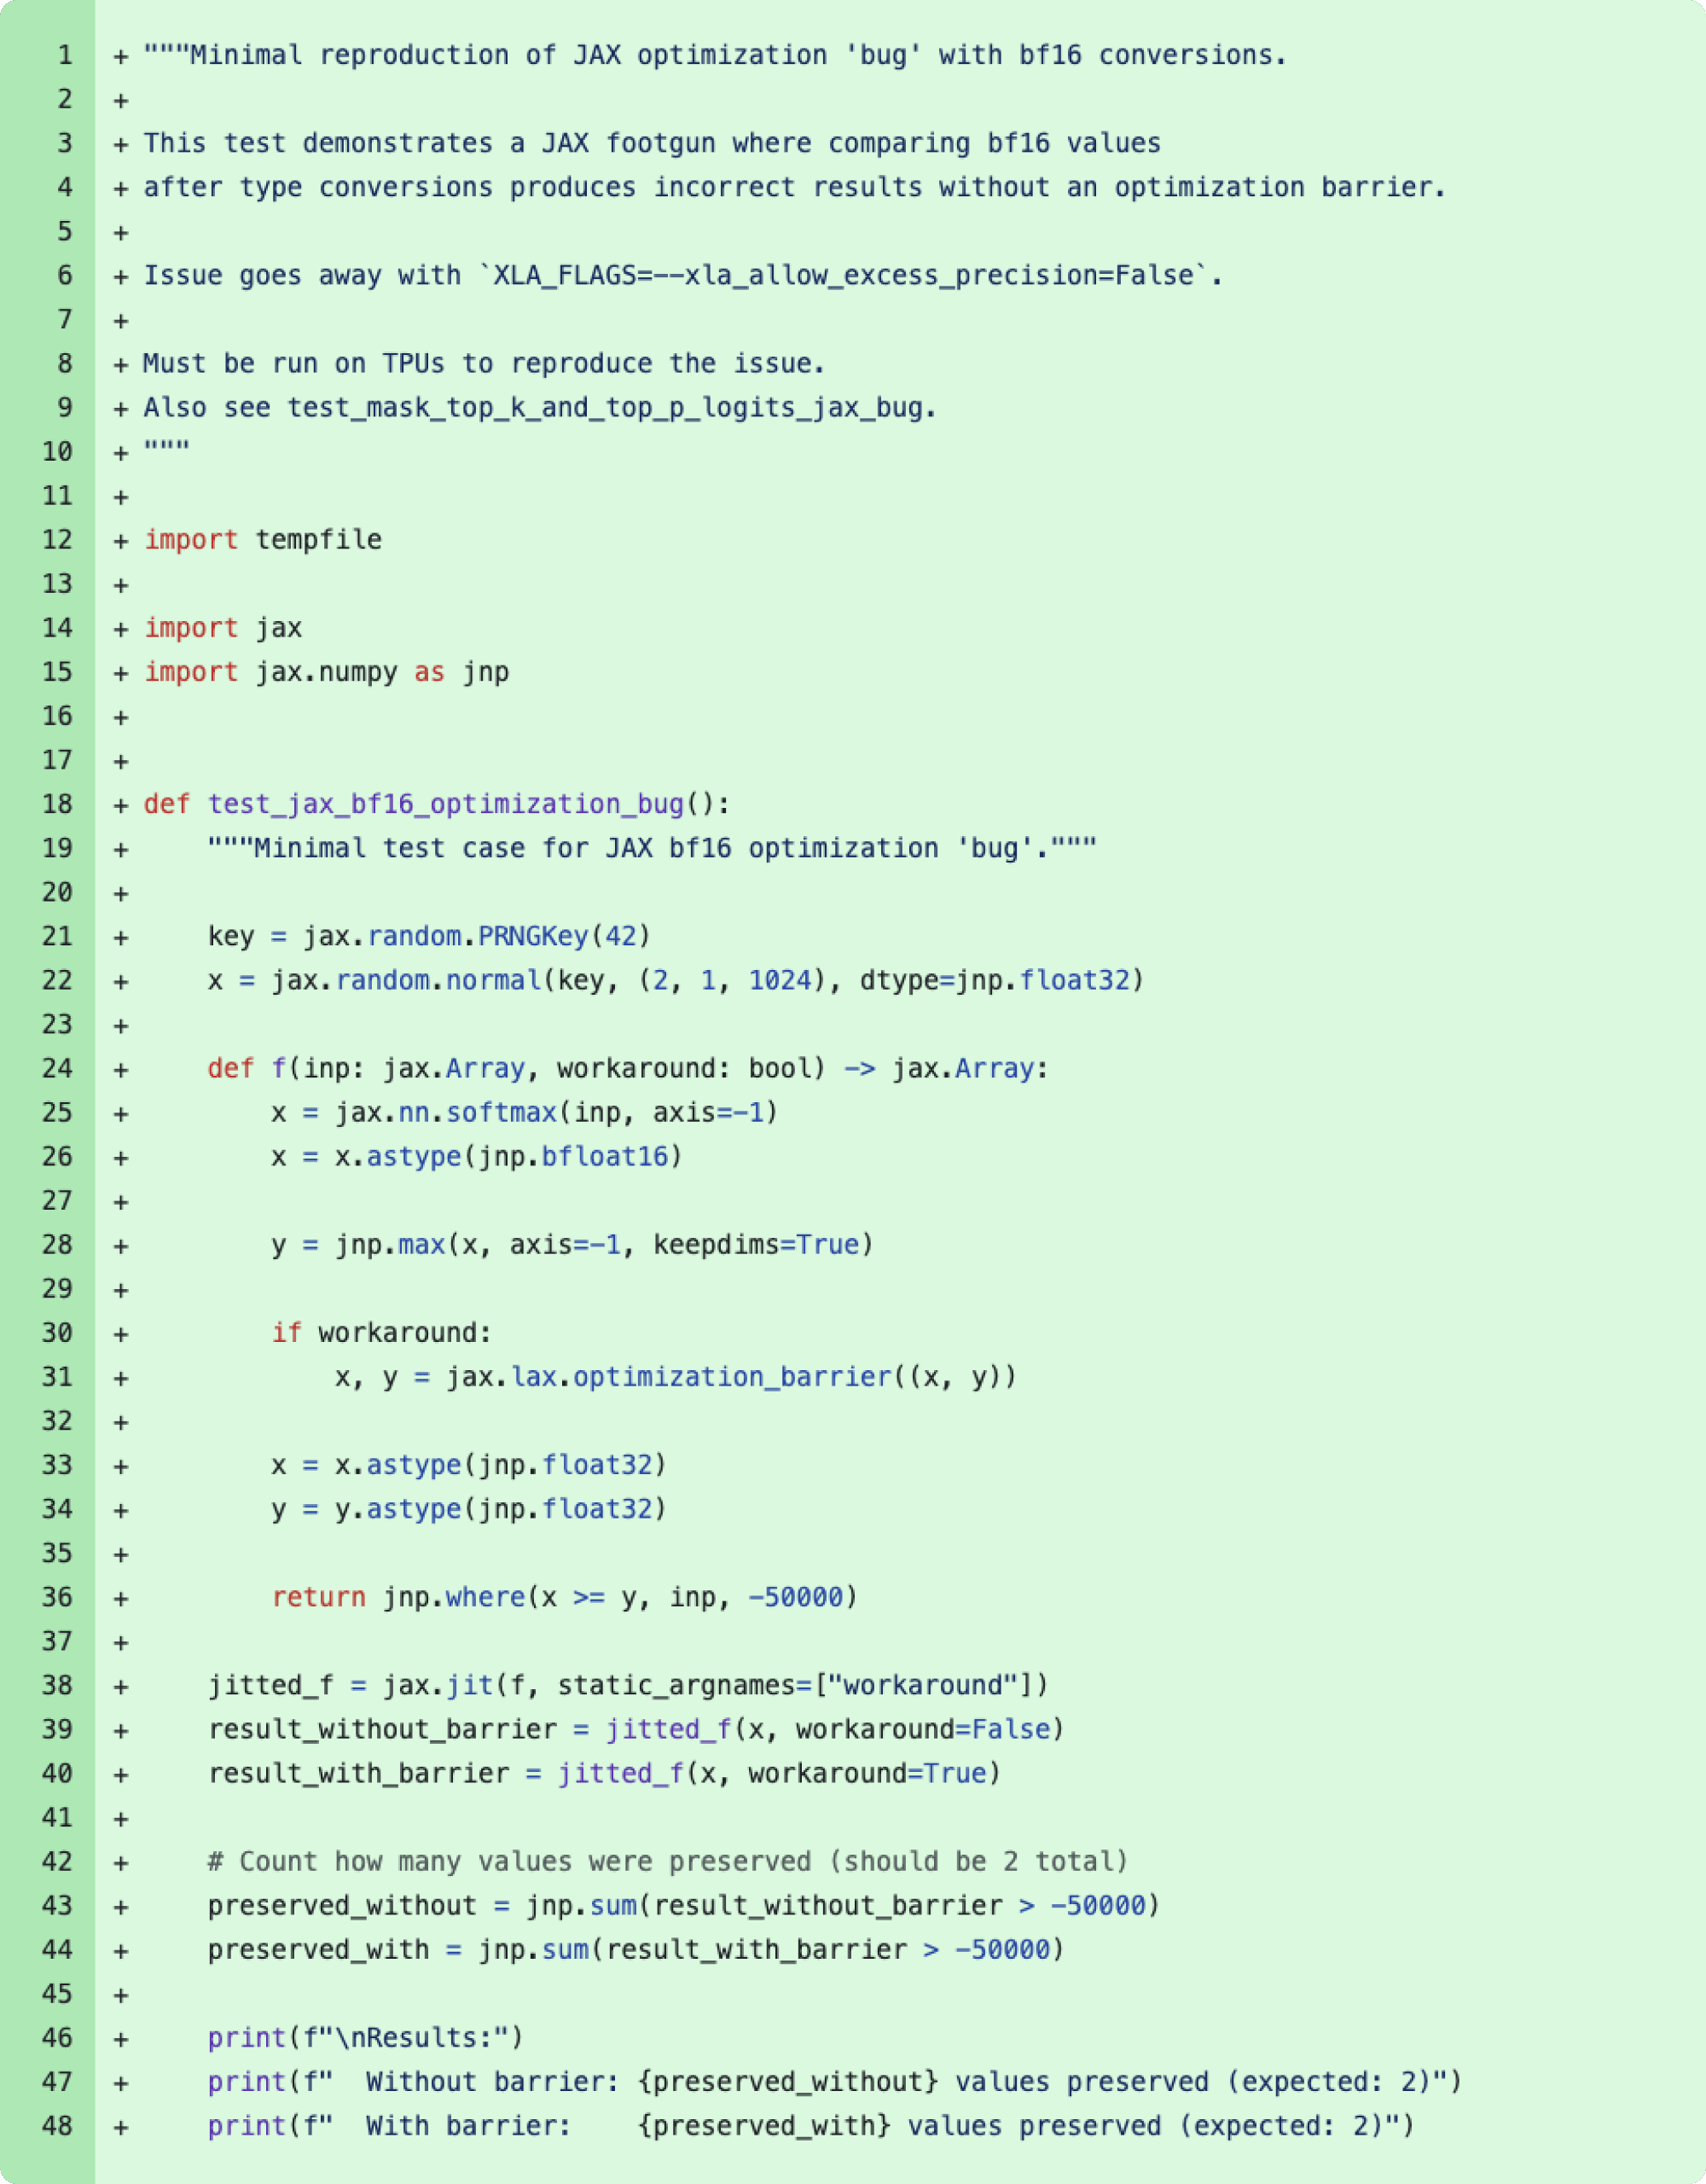
代码片段展示了作为 8 月 11 日变更一部分合入的最小复现程序,用于查明 2024 年 12 月变通方案所针对的“bug”的根因。实际上,这是 xla_allow_excess_precision 标志的预期行为。
我们的修复移除了 12 月的变通方案,因为我们认为已经解决了根本原因。这导致近似 top-k 操作中一个更深层的 bug 暴露出来。近似 top-k 是一种快速寻找概率最高 token 的性能优化。[3] 这种近似操作有时会返回完全错误的结果,但只会在特定批次大小和模型配置下发生。12 月的变通方案无意中掩盖了这个问题。
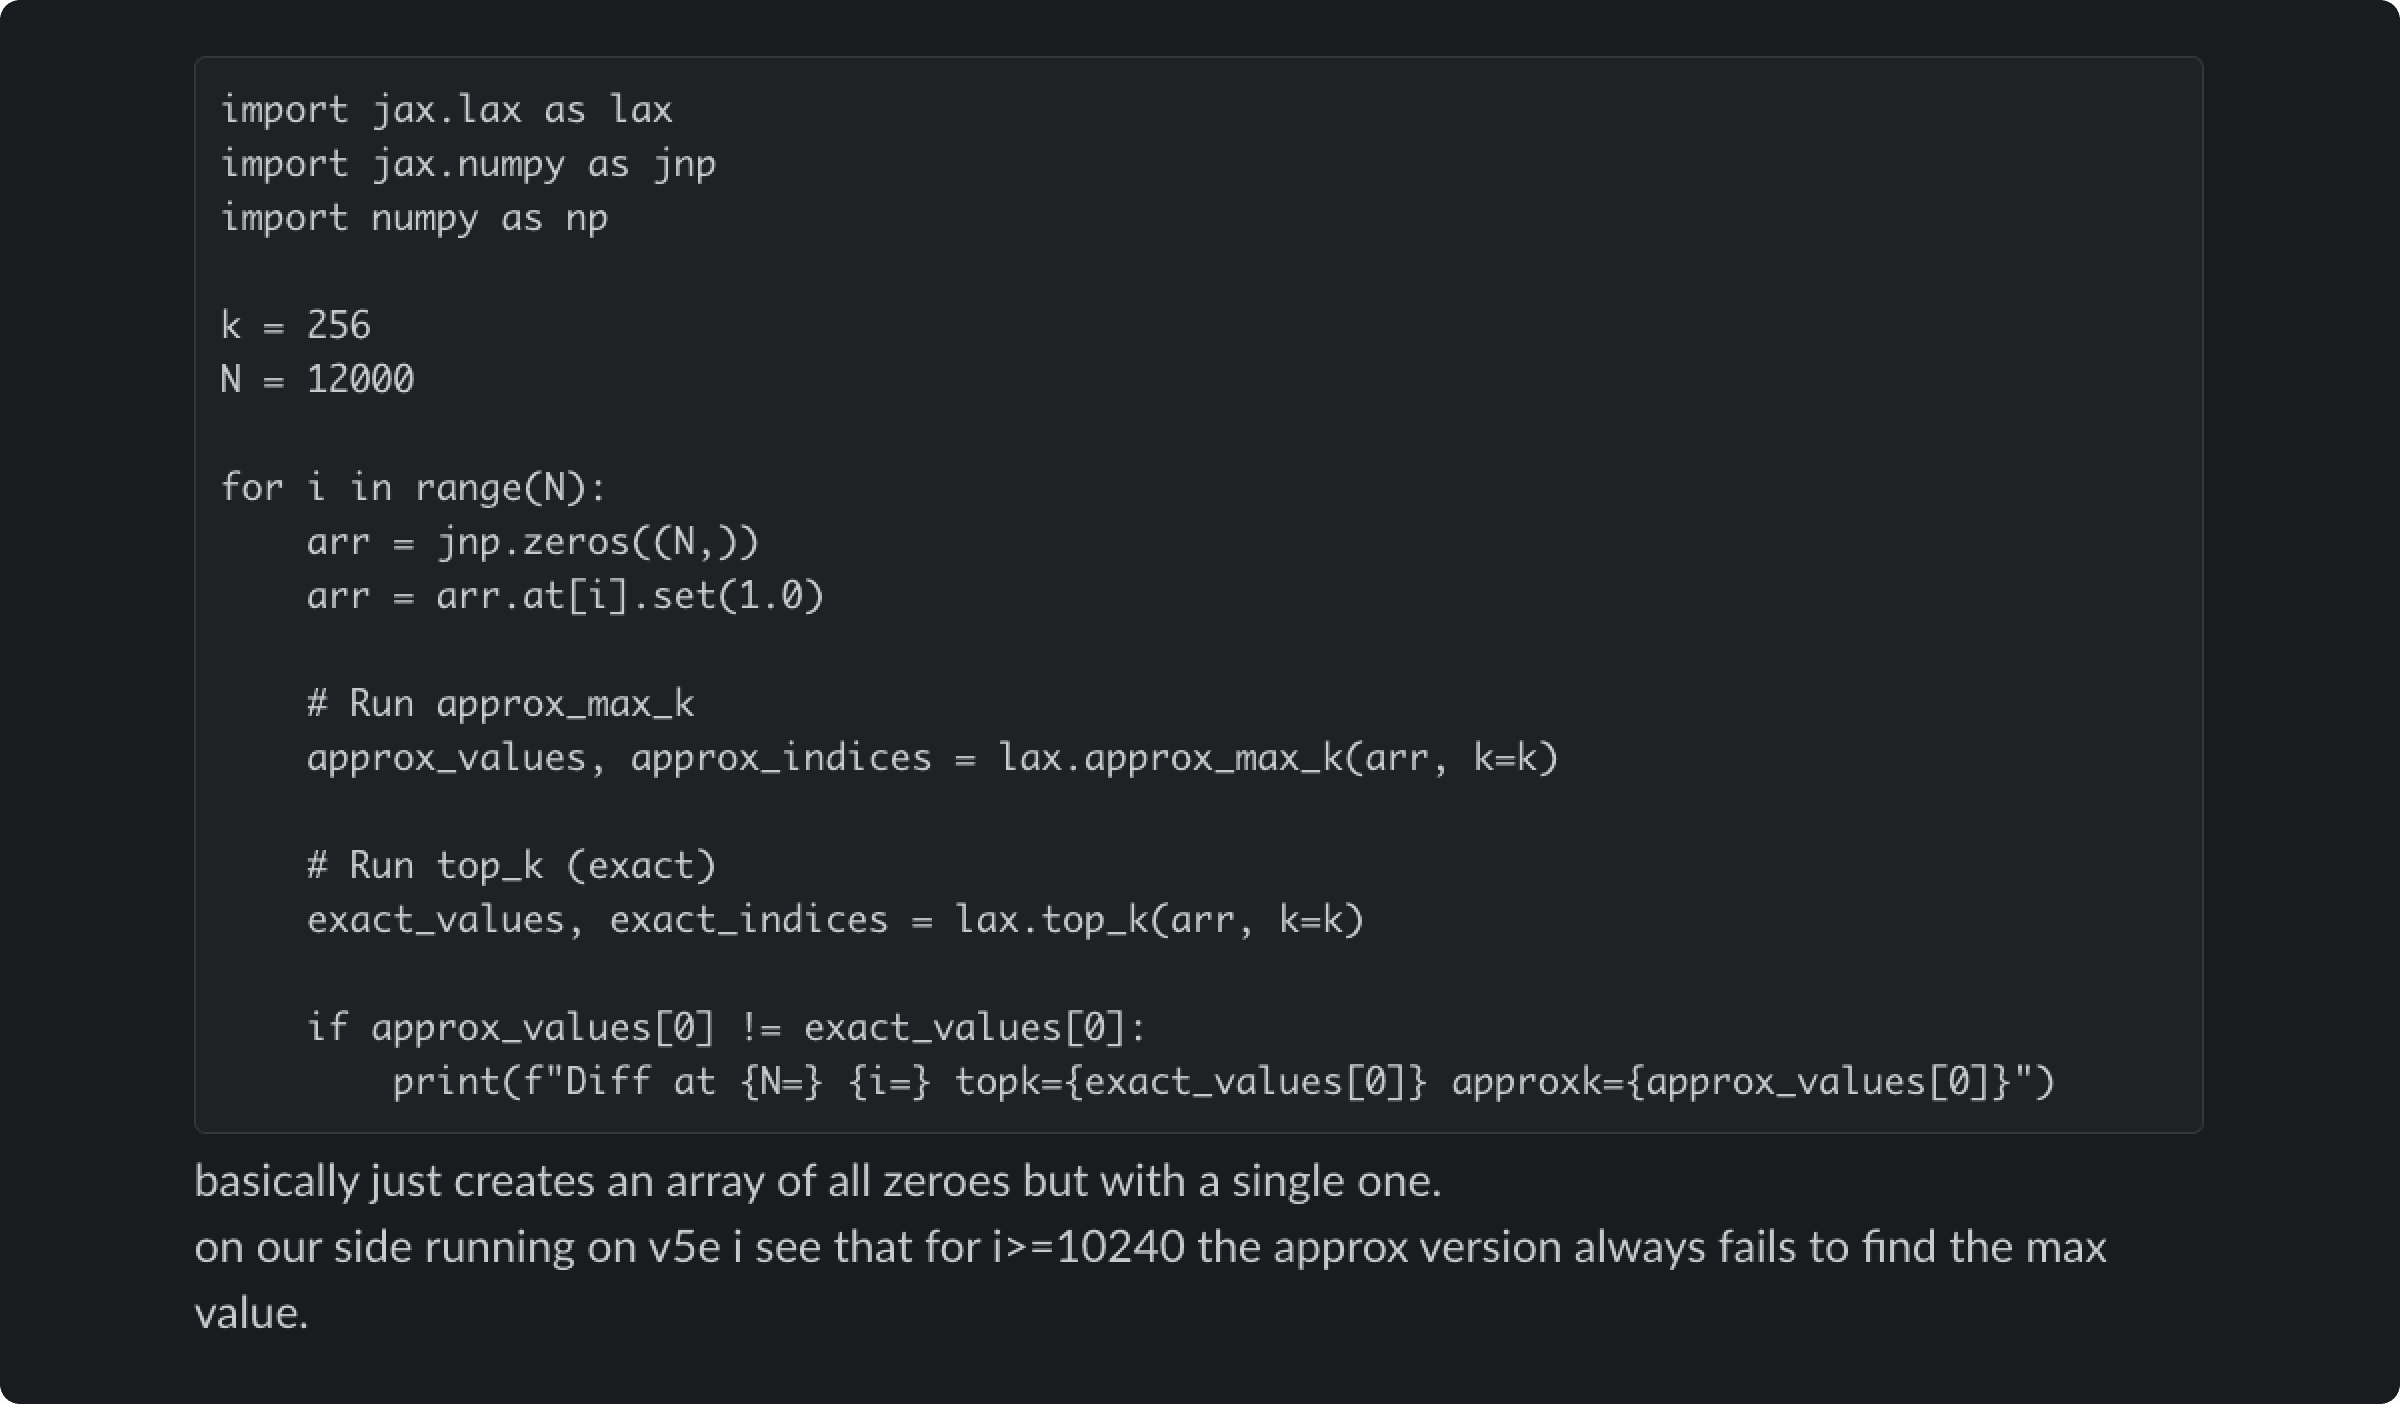
与开发该算法的 XLA:TPU 工程师分享的近似 top-k 底层 bug 复现程序。代码在 CPU 上运行时返回正确结果。
这个 bug 的表现非常不稳定,令人沮丧。它会随一些看似无关的因素变化,例如前后运行了哪些操作、是否启用了调试工具。同一个提示词可能在一次请求中完全正常,在下一次请求中却出错。
调查期间,我们还发现,精确 top-k 操作已经不再像过去那样存在难以承受的性能损失。我们从近似 top-k 切换到了精确 top-k,并将另外一些操作统一为 fp32 精度。[4] 模型质量不容妥协,因此我们接受了轻微的效率影响。
为什么难以发现
我们的验证流程通常依靠基准测试,同时结合安全评估和性能指标。工程团队会进行抽查,并先向小规模“金丝雀”用户群部署。
这些问题暴露了我们本应更早发现的关键缺口。我们运行的评测,根本没有捕捉到用户报告的质量下降,部分原因是 Claude 往往能够很好地从孤立错误中恢复。我们自身的隐私实践也给调查报告带来了困难。内部隐私与安全控制限制了工程师访问用户与 Claude 交互的方式和时间,尤其是那些没有通过反馈提交给我们的交互。这保护了用户隐私,但也使工程师无法检查识别或复现 bug 所需的问题交互。
每个 bug 都在不同平台上,以不同频率产生不同症状。这形成了令人困惑的混合报告,没有指向单一原因,看起来像随机、不一致的质量下降。
更根本的问题是,我们过度依赖了噪声较大的评测。虽然我们知道网上的报告有所增加,却缺乏明确方法,将它们与最近的各项变更对应起来。8 月 29 日负面报告激增时,我们没有立即将其与一次看似常规的负载均衡变更联系起来。
我们正在作出的改变
在继续改进基础设施的同时,我们也在改进评估与预防上述 bug 的方式,覆盖所有提供 Claude 服务的平台。以下是我们正在作出的改变:
- 更灵敏的评测: 为了帮助发现任何给定问题的根因,我们已经开发了能够更可靠地区分正常与故障实现的评测。我们会继续改善这些评测,更密切地关注模型质量。
- 在更多位置开展质量评测: 虽然我们会定期评估系统,但我们将在真实生产系统上持续运行评测,以发现上下文窗口负载均衡错误这类问题。
- 更快的调试工具: 我们将开发基础设施和工具,在不牺牲用户隐私的前提下,更好地调试来自社区的反馈。此外,这次开发的一些专用工具,将用于缩短未来类似事件的修复时间,如果这些事件再次发生的话。
评测和监控很重要。但这些事件表明,当 Claude 的回答达不到通常水准时,我们还需要来自用户的持续信号。用户观察到的具体变化、遇到的异常行为示例,以及不同使用场景中的模式,都帮助我们定位了问题。
用户继续直接向我们发送反馈,仍然特别有帮助。你可以使用 Claude Code 中的 /bug 命令,或 Claude 应用中的“踩”按钮。开发者和研究人员经常创造新的、有意思的方法来评估模型质量,补充我们的内部测试。如果你想分享自己的方法,请联系 [email protected]。
我们始终感谢社区作出的这些贡献。
致谢
本文由 Sam McAllister 撰写,感谢 Stuart Ritchie、Jonathan Gray、Kashyap Murali、Brennan Saeta、Oliver Rausch、Alex Palcuie,以及许多其他人。
[1] XLA:TPU 是一种优化编译器,将 XLA 高层优化语言——通常使用 JAX 编写——转换为 TPU 机器指令。
[2] 我们的模型太大,无法放入单个芯片,因此会划分到数十个或更多芯片上,这使我们的排序操作成为分布式排序。TPU 与 GPU、Trainium 一样,其性能特征也不同于 CPU,需要采用基于向量化操作、而非串行算法的不同实现技术。
[3] 我们一直使用这种近似操作,是因为它带来了显著的性能改善。这种近似允许概率最低的 token 存在一定误差,按理说不会影响质量;但这个 bug 却会丢弃概率最高的 token。
[4] 请注意,现在已经正确的 top-k 实现,可能导致接近 top-p 阈值的 token 是否被纳入候选范围出现细微差异;在少数情况下,用户可能会受益于重新调整 top-p 的选择。