原文:Scaling Managed Agents: Decoupling the brain from the hands
作者:Lance Martin、Gabe Cemaj、Michael Cohen / Anthropic
原文发布日期:2026 年 4 月 8 日
本文在 SunAI 论坛翻译转载。原文版权归原权利人所有。
请按照我们的文档,开始使用 Claude Managed Agents。
工程博客一直在探讨如何构建有效的智能体,以及如何为长时间运行的任务设计运行框架(harness)。这些工作有一个共同点:运行框架中包含了关于 Claude 无法独立完成哪些事情的假设。然而,我们需要经常重新审视这些假设,因为随着模型能力提升,它们可能会过时。
举一个例子:在此前的工作中,我们发现,当 Claude Sonnet 4.5 察觉到自己即将达到上下文限制时,会提前结束任务——这种行为有时被称为“上下文焦虑”。我们通过在运行框架中加入上下文重置来解决这个问题。但当我们将同一个运行框架用于 Claude Opus 4.5 时,发现这种行为已经消失了。上下文重置反而成了多余的负担。
我们预计运行框架会继续演进。因此,我们构建了 Managed Agents:这是 Claude Platform 中的一项托管服务,通过一组精简的接口,代你运行长周期智能体。这些接口的设计目标,是比任何具体实现都更长久,包括我们今天正在运行的实现。
构建 Managed Agents 意味着要解决计算领域一个由来已久的问题:如何为“尚未被设想出来的程序”设计系统。几十年前,操作系统通过将硬件虚拟化为足够通用的抽象——进程、文件——解决了这个问题,使尚未诞生的程序也能使用它们。这些抽象比底层硬件存在得更久。read() 命令不关心自己访问的是 20 世纪 70 年代的磁盘组,还是现代 SSD。上层抽象保持稳定,底层实现则可以自由变化。
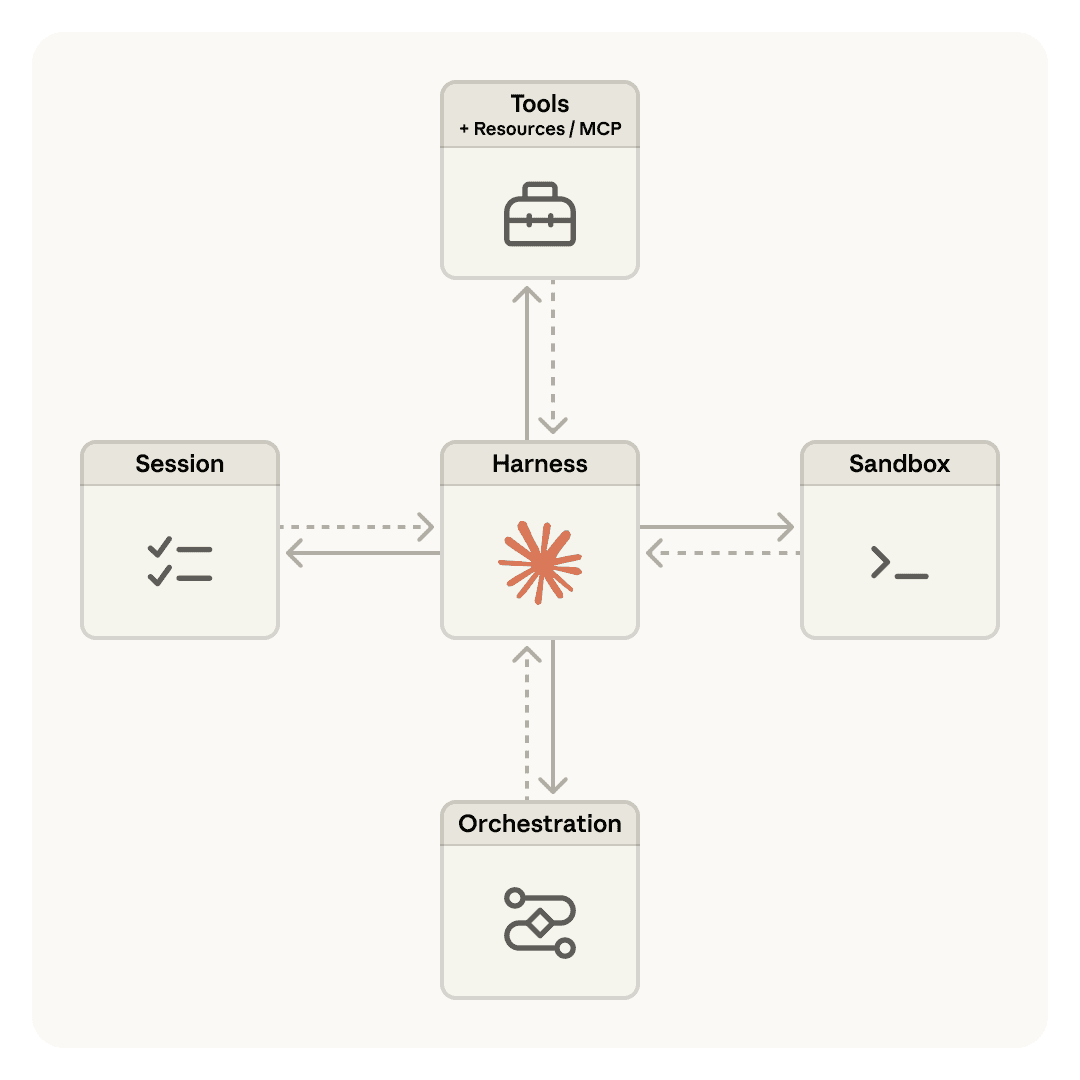
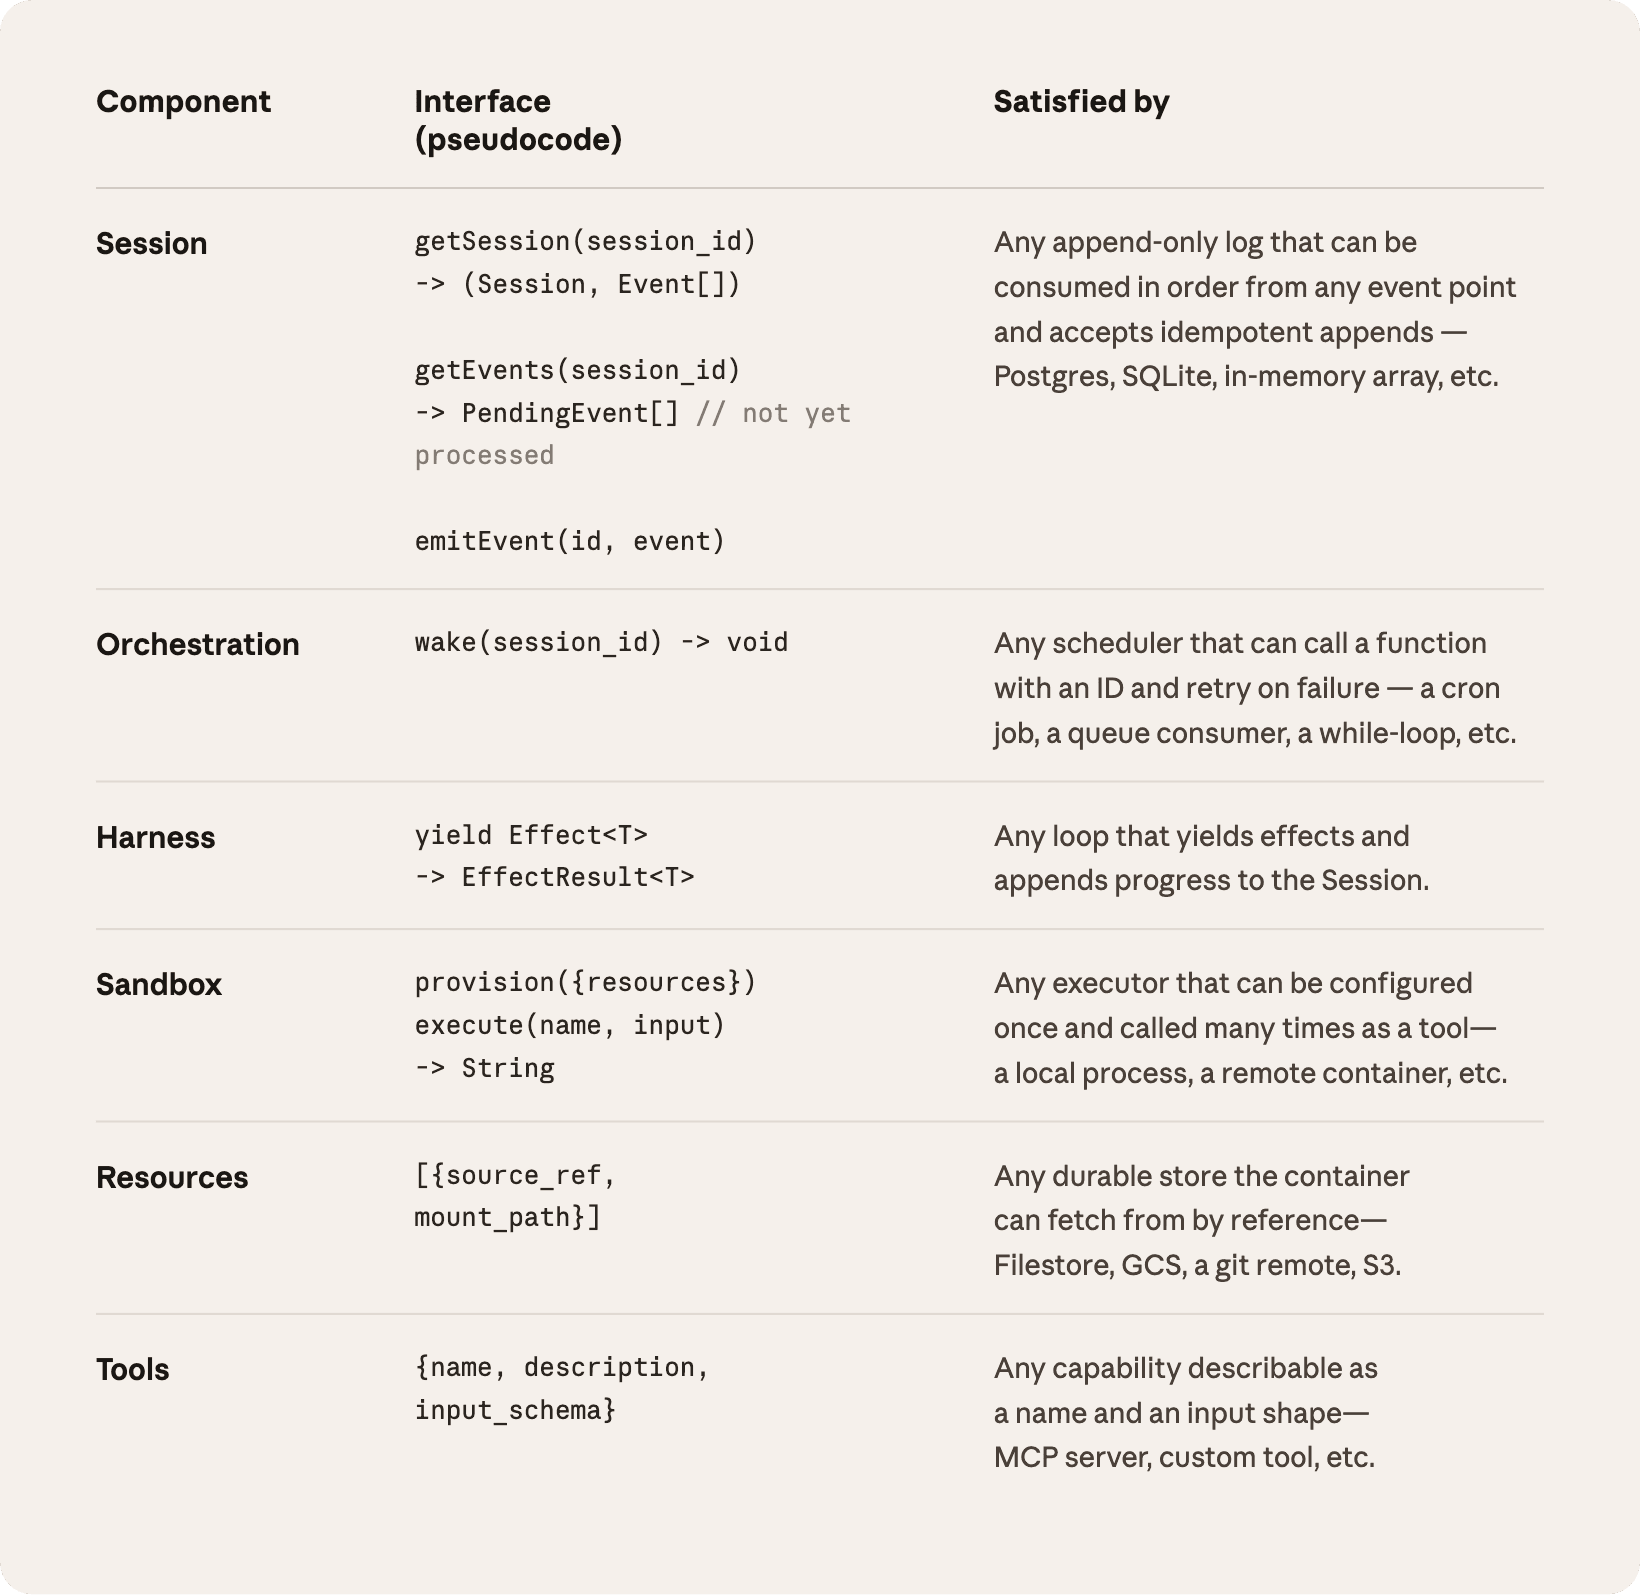
Managed Agents 采用相同的模式。我们对智能体的各个组件进行了虚拟化:会话(session,记录所有已发生事项的仅追加日志)、运行框架(harness,调用 Claude,并将 Claude 的工具调用路由到相应基础设施的循环),以及沙箱(sandbox,Claude 可以运行代码、编辑文件的执行环境)。这样,每个组件的实现都可以替换,而不影响其他组件。我们对这些接口的形式有明确的设计取向,但不限定接口背后运行什么。
不要养一只“宠物”
最初,我们将所有智能体组件放在同一个容器中,这意味着会话、智能体运行框架和沙箱共享一个环境。这种方式有一些好处,例如,文件编辑就是直接的系统调用,也不需要设计服务边界。
但将所有东西耦合在同一个容器中,让我们遇到了一个老牌基础设施问题:我们养了一只“宠物”。在“宠物与牲畜”的类比中,宠物是有名字、需要精心照料、不能轻易失去的个体,而牲畜则可以相互替换。在我们的场景中,服务器成了那只宠物:容器一旦故障,会话就会丢失;容器如果没有响应,我们就必须照料它,直到它恢复正常。
照料容器意味着调试卡住、没有响应的会话。我们唯一能观察内部情况的窗口,是 WebSocket 事件流,但它无法告诉我们故障发生在什么位置。这意味着,运行框架中的 bug、事件流中的丢包,或者容器离线,表现出来都一样。要弄清楚哪里出了问题,工程师必须进入容器打开一个 shell。但由于这个容器往往还保存着用户数据,这种方式实际上意味着我们缺乏调试能力。
第二个问题是,运行框架假定 Claude 处理的所有东西,都与它一起位于容器中。当客户要求我们将 Claude 连接到他们的虚拟私有云时,他们要么需要将自己的网络与我们的网络建立对等连接,要么需要在自己的环境中运行我们的运行框架。当我们想将运行框架连接到不同的基础设施时,一个固化在其中的假设就成了问题。
将“大脑”与“双手”解耦
我们最终采用的解决方案,是将我们所称的“大脑”(Claude 及其运行框架),与“双手”(执行操作的沙箱和工具)以及“会话”(会话事件日志)分别解耦。每一部分都变成了一个接口,对其他部分只作很少的假设,而且每一部分都可以独立发生故障或被替换。
运行框架离开容器。 将大脑与双手解耦,意味着运行框架不再位于容器内部。它调用容器的方式,与调用任何其他工具相同:execute(name, input) → string。容器变成了可以替换的“牲畜”。如果容器宕掉,运行框架就把这次故障作为工具调用错误捕获,并传回给 Claude。如果 Claude 决定重试,就可以按照标准流程重新初始化一个新容器:provision({resources})。我们不再需要照料故障容器,让它恢复正常。
从运行框架故障中恢复。 运行框架也变成了可以替换的“牲畜”。由于会话日志位于运行框架之外,运行框架内部没有任何东西必须在崩溃后保留下来。某个运行框架发生故障时,可以通过 wake(sessionId) 启动一个新的实例,使用 getSession(id) 取回事件日志,再从最后一个事件继续执行。在智能体循环期间,运行框架通过 emitEvent(id, event) 向会话写入信息,以保留持久的事件记录。
安全边界。 在耦合设计中,Claude 生成的任何不可信代码,都在存有凭据的同一个容器中运行。因此,提示注入只需要说服 Claude 读取自己的环境。一旦攻击者拿到这些令牌,就可以创建全新的、不受限制的会话,并将工作委派给它们。缩小权限范围是一种显而易见的缓解措施,但这仍然包含了一个假设:Claude 使用受限令牌时,无法做某些事情——而 Claude 正变得越来越聪明。结构性的修复方法,是确保 Claude 生成的代码所运行的沙箱永远无法访问这些令牌。
我们采用了两种模式来确保这一点。认证可以与资源绑定,也可以保存在沙箱之外的凭据保险库中。对于 Git,我们在沙箱初始化期间使用各仓库的访问令牌克隆仓库,并将认证接入本地 Git 远程配置。在沙箱内部可以执行 Git push 和 pull,而智能体无需亲自处理令牌。对于自定义工具,我们支持 MCP,并将 OAuth 令牌保存在安全的凭据保险库中。Claude 通过专用代理调用 MCP 工具;这个代理接收与会话关联的令牌,然后从凭据保险库中获取对应的凭据,并调用外部服务。运行框架始终不会获知任何凭据。
会话不等于 Claude 的上下文窗口
长周期任务往往会超出 Claude 上下文窗口的长度,而解决这个问题的标准方法,都涉及对保留哪些内容作出不可逆的决定。我们在此前关于上下文工程的工作中探讨过这些技术。例如,上下文压缩使 Claude 能够保存上下文窗口的摘要,记忆工具则使 Claude 能够将上下文写入文件,从而实现跨会话学习。这些方法还可以与上下文裁剪结合使用,选择性地移除旧工具结果或思考块等 token。
但选择性保留或丢弃上下文的不可逆决定,可能导致失败。我们很难知道后续轮次会需要哪些 token。如果消息经过上下文压缩步骤转换,运行框架就会将被压缩的消息从 Claude 的上下文窗口中移除,而这些消息只有在被存储的情况下才能恢复。已有研究探索过一种解决方法:将上下文存储为位于上下文窗口之外的对象。例如,上下文可以是 REPL 中的一个对象,LLM 通过编写代码进行筛选或切片,以程序化方式访问它。
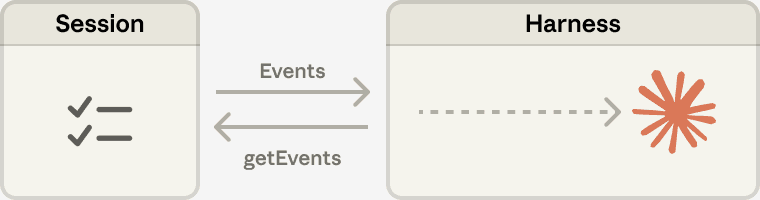
在 Managed Agents 中,会话提供了同样的好处,充当位于 Claude 上下文窗口之外的上下文对象。不过,上下文不是存储在沙箱或 REPL 中,而是持久保存在会话日志里。getEvents() 接口允许大脑通过按位置选择事件流切片,查询上下文。这个接口可以灵活使用:大脑可以从上次停止读取的位置继续,也可以回退到某个时刻之前的几个事件,查看事情的来龙去脉,或者重新阅读某次操作之前的上下文。
获取到的任何事件,也可以先在运行框架中进行转换,再传入 Claude 的上下文窗口。这些转换可以是运行框架中编码实现的任何处理,包括为获得较高提示缓存命中率而组织上下文,以及进行上下文工程。我们将会话中可恢复的上下文存储,与运行框架中可以自由实施的上下文管理分开,因为我们无法预测未来模型具体需要什么样的上下文工程。这些接口将上下文管理交给运行框架,只保证会话能够持久保存,并且可供查询。
多个大脑,多双手
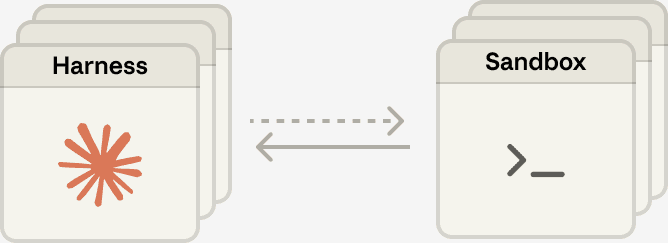
多个大脑。 将大脑与双手解耦,解决了我们最早收到的一项客户抱怨。当团队希望 Claude 操作他们自己 VPC 中的资源时,唯一的办法是将他们的网络与我们的网络建立对等连接,因为容纳运行框架的容器假定每个资源都位于它旁边。当运行框架不再位于容器中时,这个假设也就消失了。同样的变化还带来了性能收益。最初,我们将大脑放在容器里,这意味着有多少个大脑,就需要多少个容器。对于每个大脑,在容器准备就绪之前,都无法进行推理;每个会话一开始就必须承担完整的容器初始化成本。每个会话,即便永远不会使用沙箱,也都必须克隆仓库、启动进程,并从我们的服务器获取待处理事件。
这段空等时间体现在首 token 延迟(time-to-first-token,TTFT)中,它衡量会话从接受任务到输出第一个响应 token 之间需要等待多久。TTFT 是用户感受最明显的延迟。
将大脑与双手解耦,意味着只有在需要时,大脑才通过工具调用 execute(name, input) → string 来准备容器。因此,不需要立即使用容器的会话,就不用等待容器。编排层一旦从会话日志中取出待处理事件,就可以开始推理。采用这种架构后,我们的 p50 TTFT 降低了约 60%,p95 则降低了超过 90%。扩展到多个大脑,只需要启动多个无状态运行框架,并且仅在需要时将它们连接到双手。
多双手。 我们还希望能够让每个大脑连接到多双手。在实践中,这意味着 Claude 必须对多个执行环境进行推理,并决定将工作发送到哪里——这比在单个 shell 中操作,对认知能力的要求更高。我们最初将大脑放在单个容器中,是因为早期模型还不具备这种能力。随着智能水平提升,单个容器反而成了限制:当那个容器发生故障时,大脑正在操作的每一只手的状态都会丢失。
将大脑与双手解耦,使每只手都成为一个工具:execute(name, input) → string,输入名称和参数,返回一个字符串。这个接口支持任何自定义工具、任何 MCP 服务器,以及我们自己的工具。运行框架不知道沙箱究竟是一个容器、一部手机,还是一个宝可梦模拟器。而且,由于任何一只手都不与任何一个大脑耦合,大脑之间可以相互移交这些手。
结论
我们面临的是一个由来已久的挑战:如何为“尚未被设想出来的程序”设计系统。操作系统通过将硬件虚拟化为足够通用、能够支持尚未诞生程序的抽象,延续了数十年。对于 Managed Agents,我们的目标是设计一个系统,能够容纳未来围绕 Claude 构建的运行框架、沙箱或其他组件。
Managed Agents 是遵循同样思路的元运行框架(meta-harness),不预设 Claude 未来需要哪一种具体的运行框架。相反,它通过通用接口,支持许多不同的运行框架。例如,Claude Code 是一个优秀的运行框架,我们在各种任务中广泛使用它。我们也已经展示,针对特定任务设计的智能体运行框架,在狭窄领域中表现出色。Managed Agents 能够容纳其中任何一种,随时间推移适应 Claude 的智能水平。
元运行框架的设计,意味着对 Claude 周围的接口作出明确选择:我们预计 Claude 会需要操作状态(会话)和执行计算(沙箱)的能力。我们也预计,Claude 会需要扩展到多个大脑和多双手的能力。我们设计这些接口,是为了让这些组件能够在长时间跨度内可靠、安全地运行。但对于 Claude 将需要多少个大脑、多少双手,以及它们位于何处,我们不作任何假设。
致谢
本文由 Lance Martin、Gabe Cemaj 和 Michael Cohen 撰写。感谢 Nodir Turakulov 和 Jeremy Fox 就这些话题进行的有益交流。特别感谢 Agents API 团队和 Jake Eaton 作出的贡献。