Xiaomi-OCR-0 是小米开源的 0.8B 文档理解模型,以 Qwen3.5-0.8B-Base 为基础,使用约 1.7 亿条 OCR 相关样本训练。模型权重采用 Apache-2.0 许可证,除了识别文字,还能解析文档结构、提取指定字段,以及回答图片中的文字内容问题。
技术报告和模型权重于 2026 年 9 月 30 日发布,项目同时提供本地网页 Demo、MCP 服务和 Agent Skill。
能做什么
- 将文档图片解析为 Markdown,公式输出为 LaTeX,表格经过后处理转换为嵌入 Markdown 的 HTML 表格。
- 按指定字段进行关键信息抽取(KIE),输出 JSON。
- 对文档图片进行视觉问答(VQA),例如查询票据上的金额、日期,或询问图表中的内容。
- 在本地网页中上传 PDF,逐页解析;通过 MCP 把这些能力接入 Agent。
PDF 需要先渲染成图片,再交给模型识别。网页 Demo 中,PDF 输入用于文档解析;KIE 和 VQA 使用图片输入。
成绩怎么样
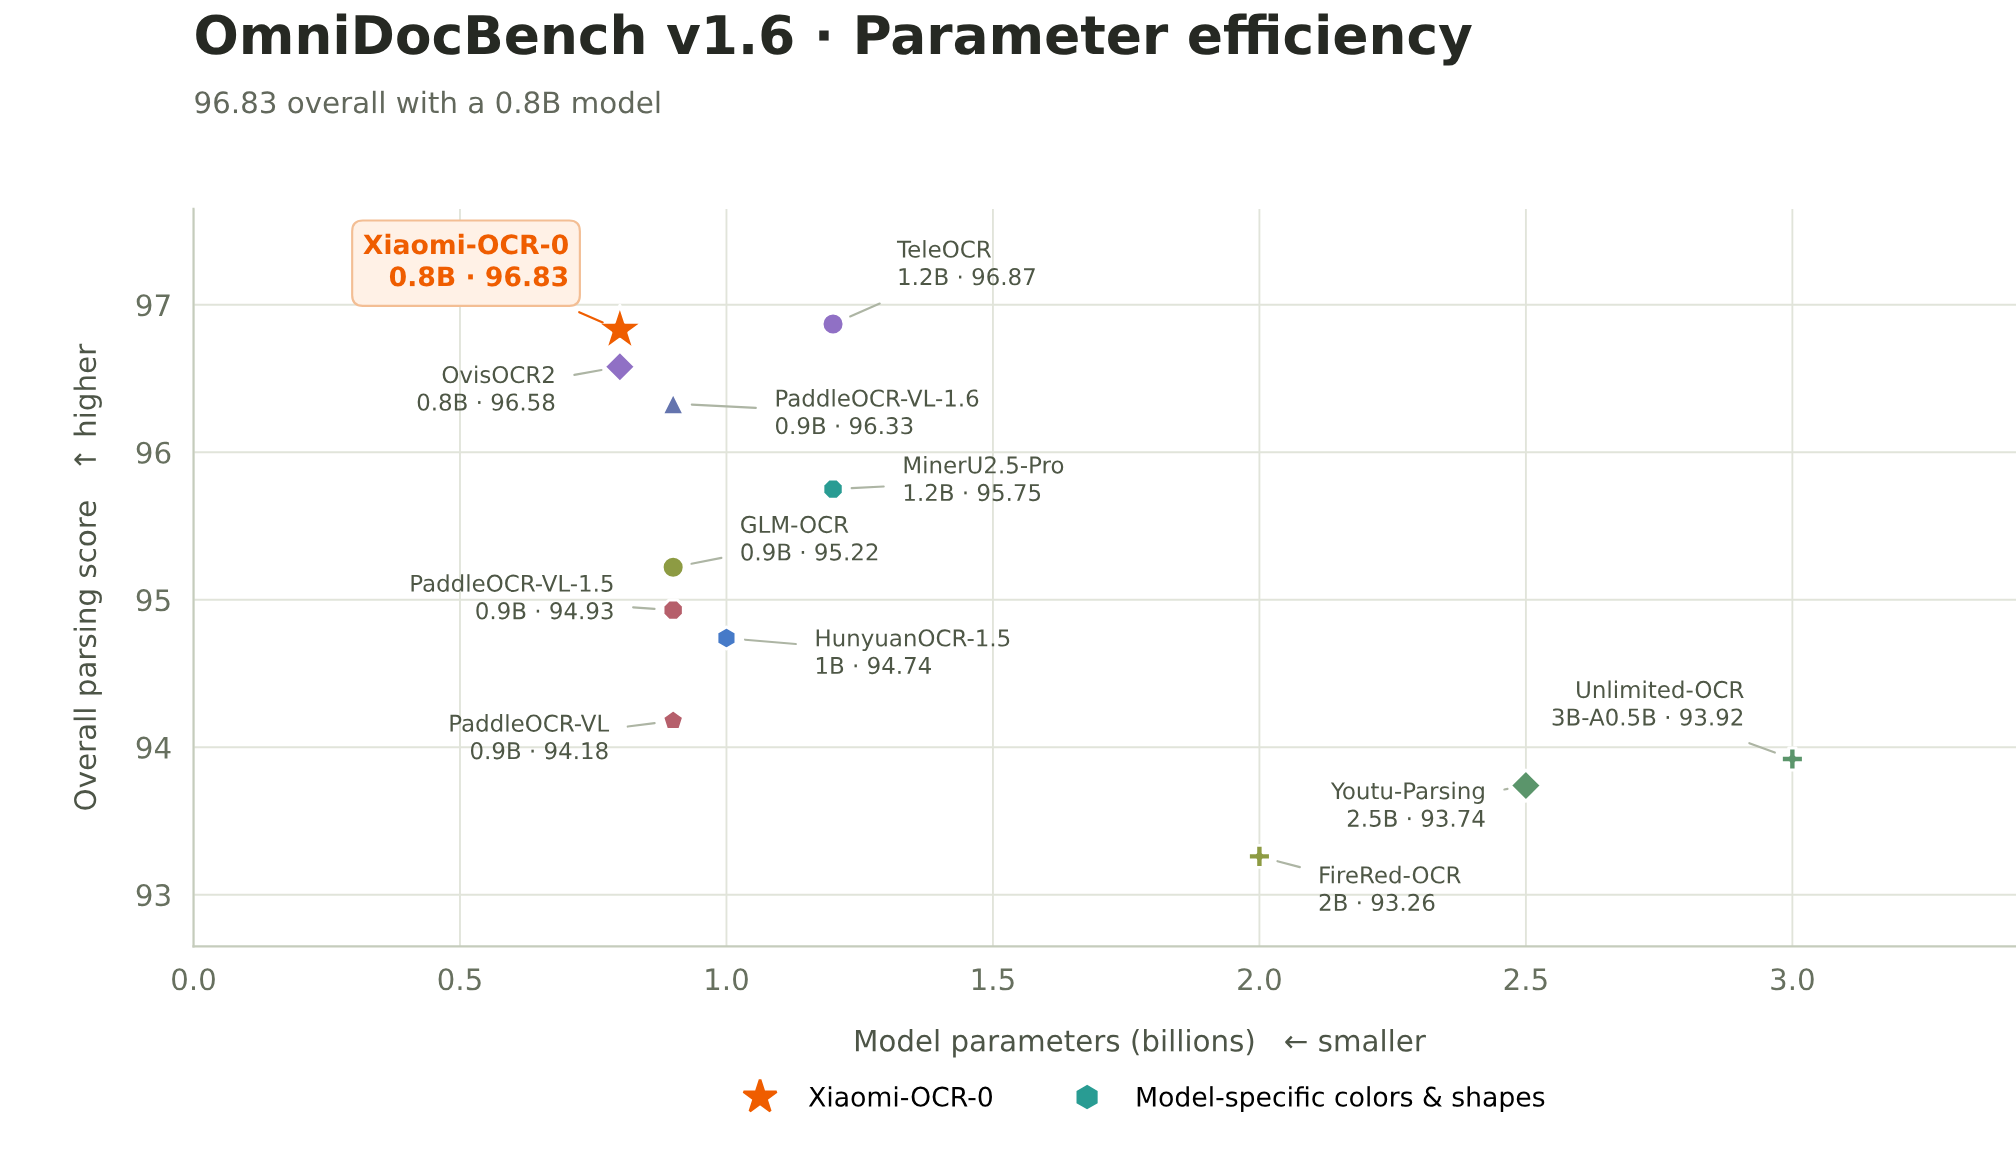
下表来自项目方公布的对比结果,三列均为相应基准的 Overall 得分,越高越好。“—”表示该表未提供成绩。
| 模型 | 参数量 | OmniDocBench v1.6 | Real5-OmniDocBench | Wild-OmniDocBench |
|---|---|---|---|---|
| Xiaomi-OCR-0 | 0.8B | 96.83 | 95.24 | 87.94 |
| TeleOCR | 1.2B | 96.87 | — | 88.53 |
| OvisOCR2 | 0.8B | 96.58 | 92.29 | 87.91 |
| PaddleOCR-VL-1.6 | 0.9B | 96.33 | 93.19 | 87.36 |
| MinerU2.5-Pro | 1.2B | 95.75 | 88.94 | 87.33 |
| GLM-OCR | 0.9B | 95.22 | 90.32 | 85.08 |
Xiaomi-OCR-0 在这组结果中,Real5 得分最高;OmniDocBench v1.6 和 Wild 则略低于 TeleOCR。同为 0.8B 的 OvisOCR2 与它在 OmniDocBench v1.6、Wild 上的差距较小。
文档问答方面,DocVQA、InfoVQA、ChartQA、OCRBench、TextVQA 五项得分的算术平均为 83.2,高于 Qwen3.5-0.8B 的 72.9 和 Qwen3.5-2B 的 80.9,低于 Qwen3.5-4B 的 84.9。这说明 OCR 专项训练带来了收益,不代表它在通用能力上超过更大的模型。
上述三个文档解析基准使用的都是两阶段流程:先检测版面区域,再裁剪识别、恢复阅读顺序并组装结果。 单独调用模型做整页识别,不等于复现这组成绩。95.24 也不是“任意文档有 95.24% 的字符识别正确率”。
自托管前需要准备什么
项目网页与 MCP 要求 Python 3.10 或以上;推理框架还有自己的 Python、GPU 和驱动要求。下面 vLLM 路线以 Linux、Python 3.12 和兼容的 NVIDIA GPU 为例,Windows 可使用配置好 GPU 的 WSL2。vLLM 不原生支持 Windows。
0.8B 是参数规模,不是完整服务的显存占用。实际资源还包括视觉编码、图像分辨率、上下文、推理缓存和并发请求。项目安装说明没有给出统一的最低显存或吞吐保证,不能仅凭参数量判断某张显卡能否运行。
有两条部署路线:
| 路线 | 用途与区别 |
|---|---|
| 原始权重 + vLLM / SGLang | 使用原始模型,运行时必须支持 Qwen3.5 多模态架构;本教程以 vLLM 为例 |
| 社区 BF16 包 + Ollama | 安装步骤较少,包含视觉投影器,下载约 1.8 GB;目前为实验性方案 |
路线一:vLLM + 本地网页
1. 获取项目
git clone https://github.com/xiaomi-research/Xiaomi-OCR-0.git
cd Xiaomi-OCR-0
2. 创建独立推理环境
以下安装适用于驱动满足当前 vLLM wheel 要求的环境。CUDA、驱动或平台不匹配时,应按 vLLM 官方 GPU 安装指南选择对应构建,不要混用已有 PyTorch 环境。
python3.12 -m venv .venv-vllm
source .venv-vllm/bin/activate
python -m pip install --upgrade pip
python -m pip install vllm
当前版本需要支持 Qwen3_5ForConditionalGeneration。如果启动时报架构不支持,应核对 vLLM 的模型支持和版本,而不是改成纯文本模型加载。
3. 启动模型服务
vllm serve xiaomi-research/Xiaomi-OCR-0 \
  --host 127.0.0.1 \
  --port 8000 \
  --max-model-len 16384
首次启动会下载模型,加载完成后保留该终端。项目部分说明仍使用旧组织名 SeerRay-Lab/Xiaomi-OCR-0,Hugging Face 目前将其重定向到 xiaomi-research/Xiaomi-OCR-0;服务名称应以实际接口返回为准。
在另一个终端检查模型列表:
curl -fsS http://127.0.0.1:8000/v1/models
4. 启动网页
在另一个终端进入项目目录,为网页单独创建环境:
cd Xiaomi-OCR-0
python3.12 -m venv .venv-demo
source .venv-demo/bin/activate
python -m pip install --upgrade pip
python -m pip install -r requirements.txt

export XIAOMI_OCR_LOCAL_URL=http://127.0.0.1:8000/v1
export XIAOMI_OCR_MODEL=xiaomi-research/Xiaomi-OCR-0
python demo/server.py --port 8787
如果 /v1/models 返回的模型 ID 不同,把 XIAOMI_OCR_MODEL 改为对应 ID。环境变量要在启动网页的终端中设置。
浏览器打开 http://127.0.0.1:8787,先选一张清晰图片,用整页模式确认识别正常,再测试 PDF、字段抽取和问答。整页模式不需要 PaddleX。
服务器部署时,可以通过 SSH 隧道访问网页,不必直接开放端口:
# 在自己的电脑执行,将 user 和 server 替换为服务器信息
ssh -N -L 8787:127.0.0.1:8787 user@server
然后在自己电脑打开同一地址。推理服务保持监听 127.0.0.1,网页 Demo 也只接受回环地址作为推理后端。
路线二:Ollama + 本地网页
先安装支持 Qwen3.5 的 Ollama,并确认本地服务已运行。项目记录的测试版本为 Ollama 0.35.0。
ollama pull longwayxu/xiaomi-ocr-0:bf16
这个社区包包含语言模型和视觉投影器,约 1.8 GB。进入项目目录,在网页 Python 环境中运行:
# 首次使用时创建环境并安装依赖;已有 .venv-demo 可直接激活
python3.12 -m venv .venv-demo
source .venv-demo/bin/activate
python -m pip install -r requirements.txt

export XIAOMI_OCR_BACKEND=ollama
export XIAOMI_OCR_MODEL=longwayxu/xiaomi-ocr-0:bf16
export XIAOMI_OCR_LOCAL_URL=http://127.0.0.1:11434/v1
python demo/server.py --port 8787
打开 http://127.0.0.1:8787。以上为 Bash 命令;Windows 原生环境激活虚拟环境和设置环境变量时,需要使用对应的 PowerShell 写法。
识别入口应使用项目网页或 MCP。只执行 ollama pull,不会自动配置项目所用的图片预处理、非思考提示词和解码设置。
Ollama 路线尚未确认与原始权重精度一致。项目记录的一次 Apple Silicon 小样本对齐测试中,7 个输入的 token 数全部相同,但完整回复只有 5 个相同,公式案例存在差异。这不是准确率统计,也不能将原始权重的榜单成绩直接套到 Ollama 或其他 GGUF 转换版上。
可选:启用区域解析
对于版式规整的印刷文档,可以安装 PP-DocLayoutV3 版面检测依赖,让系统按区域裁剪、并发识别,再恢复阅读顺序。
先按 PaddlePaddle 官方安装指南,为当前操作系统、Python 和 CPU/GPU 安装适配的 PaddlePaddle,然后在运行网页的环境中执行:
python -m pip install -r requirements-paddlex.txt

# 仅让版面检测使用 CPU,不会把主 OCR 模型切换到 CPU
export XIAOMI_OCR_LAYOUT_DEVICE=cpu
python demo/server.py --port 8787
该依赖清单包含 paddlex[cv] 和 shapely,不能只安装普通 paddlex。首次使用还可能下载 PP-DocLayoutV3 权重。
切换网页到区域模式后,需要实际提交一次区域解析任务确认安装完成。网页显示模型已连接,并不代表版面检测依赖也已安装。
手写、书法、古籍、场景文字及不规则版式,项目建议优先使用整页模式,以免区域切分错误导致上下文丢失。严格复现榜单还要使用项目提供的评测配置和两阶段流程,不能只看网页模式名称。
可选:接入 MCP
模型服务可用后,在项目根目录执行。下面以 vLLM 为例:
XIAOMI_OCR_LOCAL_URL=http://127.0.0.1:8000/v1 \
XIAOMI_OCR_MODEL=xiaomi-research/Xiaomi-OCR-0 \
bash skills/xiaomi-ocr/install.sh
安装脚本会创建 MCP 的 Python 环境、安装依赖并生成 mcp-config.json。将其中的服务配置合并到所用客户端的 MCP 配置中,然后重启或重新扫描服务。
如果使用 Ollama,将 URL 改成 http://127.0.0.1:11434/v1,模型名改成 longwayxu/xiaomi-ocr-0:bf16。安装脚本需要显式传入这两个变量,不能只用 XIAOMI_OCR_BACKEND=ollama 代替。
MCP 提供 ocr_image、ocr_pdf、kie_image、vqa_image 四个工具。图片/PDF 预处理、提示词、表格转换等由工具处理;MCP 环境中的区域模式依赖需要单独安装,不能用网页环境的安装结果代替。
常见问题
- 网页连不上模型: 先检查推理进程和
/v1/models,再核对网页终端中的 URL、模型 ID。切换推理后端后重启网页进程。 - 整页正常、区域报错: 检查 PaddlePaddle、
paddlex[cv]、shapely和布局权重是否装在实际使用的 Python 环境里。 - 显存不足: 降低并发、输入分辨率或上下文配置,再用自己的文档验证质量。模型参数小不代表整个推理服务只占很少显存。
- 长文输出截断: 项目默认输出预算为 4096 tokens,16384 的上下文还需容纳图片和提示词。不能把输出预算直接设成全部上下文长度。